
样例报告
dual role
混合片:代码界面 59% + AI 视频 41%,含 8 秒真实录屏。
视频拆解报告:social_account_doctor_human_v1.mp4
结论:混合制作:代码/模板渲染 59% + AI 生成视频 41%;叠加层:文字标注、字幕、标题(代码/剪辑软件合成);用到真实素材:录屏素材(8.2s)、界面截图(4.8s);声音:人声 + BGM 121.6BPM(现成曲库配乐) + 音效 1 处
- 时长 19.042s · 1080×1920 · 24.0fps · 9:16
- 镜头 10 个,平均 1.9s;转场:cut×9、start×1
- 判断置信度(按时长加权):74%;判定方式:确定性取证 + VLM 融合
- VLM 已生效(gemini-3.1-pro-preview,gemini-3.1-pro-preview-pc,gcp-gemini-3-pro-preview);由 claude 看图复核 1/10 个镜头,已并入结论
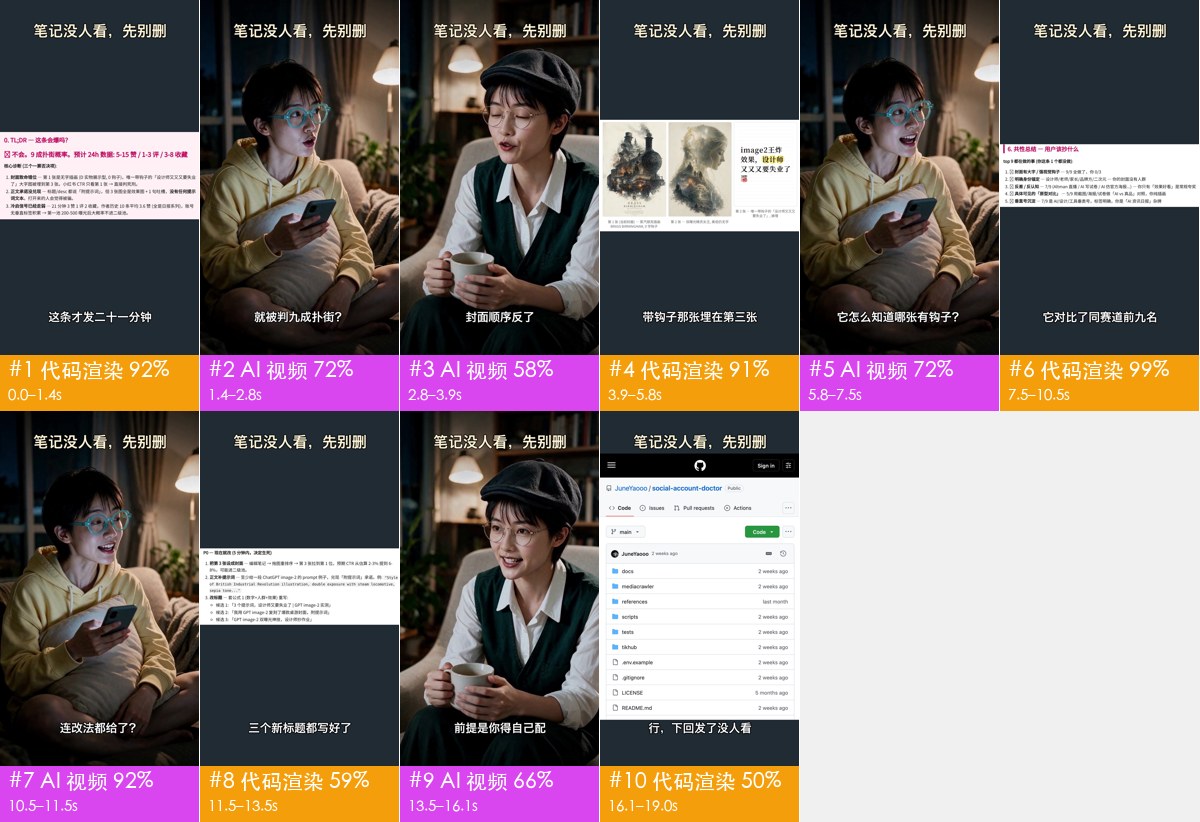
制作方式占比
| 底层画面 | 时长 | 占比 |
|---|---|---|
| 代码/模板渲染 | 11.17s | 59% |
| AI 生成视频 | 7.88s | 41% |
复刻方案
AI 视频 5 镜 → 1 个生成单元、1 次 Seedance 2.5 调用;代码渲染/录屏 5 镜 → 1 个代码工程(5 段)
- 默认引擎 Seedance 2.0(含 Mini / Fast) 不支持一次多镜头,用它要逐镜生成 5 次;这里按 Seedance 2.5 规划(单次 ≤30s、可一次出多镜头),共 1 次
- 分组规则:同场景、硬切相连的 AI 镜头合并为一次生成(S01);单次 ≤30s;单元内连续硬切尽量 ≤8s、最多 10s(S06);在叠化/淡入淡出和换场景处切开(S03)
- 声音:模型可以同时生成动作音效和环境声;口播建议单独 TTS 再混进去,方便改文案和卡时间
生成单元
| 单元 | 镜头 | 时间 | 时长 | 方式 | 衔接 |
|---|---|---|---|---|---|
| G1 | #2、#3、#5、#7、#9 | 1.4–3.9s、5.8–7.5s、10.5–11.5s、13.5–16.1s | 7.9s | 一次多镜头 | 首帧:参照原片第 2 镜首帧(shots/shot_002_first.jpg)的构图出图 |
G1 · AI 生成视频 · 镜头 #2、#3、#5、#7、#9 · 7.9s
- 参考素材:
@图片1人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;@视频1原片 1.4–3.9s、5.8–7.5s、10.5–11.5s、13.5–16.1s 片段(剪掉中间插入的画面后拼成一段):参考动作、运镜和剪辑节奏(只作参考,不复制画面) - 首帧图像提示词:真实摄影质感,年轻短发中国女子戴浅绿色复古眼镜,身穿黄色连帽衫,夜晚盘坐在客厅沙发上,胸前抱抱枕,单手拿着手机,背景有暖色落地灯与室内绿植,柔和电影光影,中景,平视视角,竖屏。
- 这几镜在成片里被插入画面隔开:生成时连着出,剪辑时再把插入画面放回去
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(几乎没有明暗分界),偏冷(日光/冷白 LED),背景略虚。人物以 @图片1 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–1.5s):固定镜头,女子微微张嘴说话,神情略带困惑与惊讶,眼睛注视前方,手指轻微握持手机,头部轻微活动,身体保持坐姿稳定,柔和夜间光影流转。
镜头2(1.5–2.5s):固定机位近景拍摄,戴报童帽和眼镜的年轻女性端着咖啡杯自然说话、眨眼,面部神情从微思索变为柔和微笑,双手稳定捧着杯子,背景台灯光影稳定,电影感室内光线。
镜头3(2.5–4.2s):固定机位中景,戴眼镜的短发女生在夜晚沙发上低头看着发光的手机,随后惊讶地张嘴抬头看向镜头前方说话,面部表情灵动,身体保持盘坐,背景暖光落地灯柔和虚化,保持写实电影感摄影质感
镜头4(4.2–5.2s):固定镜头,戴眼镜女孩抱抱枕坐在沙发上看着手机,惊讶地张大嘴巴说话,眼神聚焦屏幕,手机屏幕蓝白冷光微微闪烁照亮面部,动作自然微动。
镜头5(5.2–7.9s):图片作底图,音频驱动数字人,嘴型同步,头部微动眨眼,身体背景静止。
<details><summary>English prompt</summary>
Shot 1 (0.0-1.5s): Static shot, a young woman with short hair and glasses talking with slight confusion, holding a phone, sitting on a sofa at night, minimal head movement, cinematic cozy lighting.
Shot 2 (1.5-2.5s): Static medium close-up shot of a young East Asian woman with a newsboy cap and round glasses sitting on an armchair, holding a ceramic mug with both hands, speaking and subtly smiling. Warm cinematic lighting, blurred bookshelf and cozy practical lamp in the background.
Shot 3 (2.5-4.2s): Static medium shot, a short-haired Asian girl wearing turquoise glasses and a yellow hoodie sits cross-legged on a sofa at night holding a glowing phone, looks up in surprise and starts talking, realistic movie cinematography, subtle screen light on face, warm floor lamp in soft-focus background.
Shot 4 (4.2-5.2s): Static shot, a young woman wearing round glasses sits on a couch hugging a cushion, looking at her smartphone with an astonished expression and speaking, phone light illuminating her face.
Shot 5 (5.2-7.9s): Audio-driven avatar from image, lip sync, slight head movement and blinking, static body and background.
</details>
代码合成
一个 Remotion/HTML 工程,按文字轨和版式重建(文字、界面 100% 可控,改文案只改数据);可以让 LLM 直接写这个工程。
- 段1:镜头 #1(0.0–1.4s)
- 段2:镜头 #4(3.9–5.8s)
- 段3:镜头 #6(7.5–10.5s)
- 段4:镜头 #8(11.5–13.5s)
- 段5:镜头 #10(16.1–19.0s)
拍法、打光与剪辑
- 取景:景别 近景 100%;机位角度 平视;主体是人脸(按脸高算景别)
- 机位:固定机位(三脚架/支架/放在桌上) 66%、移动机位(稳定器/手持平移) 34%
- 打光:夜景/弱光环境光,没有专门补光。主光 正面(光从镜头方向来,主体两侧亮度接近),从下往上(屏幕/桌面反光/低位光源);光比 约 1.3:1(相差 0.4 档);中等柔度;色温偏冷(日光/冷白 LED);主体下半部偏亮:可能有来自下方的光(屏幕、桌面反光);主体和背景色温不一致:混合光源(例如暖色灯 + 冷色窗光/屏幕);背景略虚
- (画面不是实拍:以上是画面里的光影,用于写生成提示词,不是拍摄方案)
- 调色:自然(接近原色);饱和度正常、对比正常、黑位正常、整体中性
- 剪辑:每分钟 28.4 刀,平均镜头 1.9s;没有实拍镜头
| 维度 | 项目 | 结论 | 来源 |
|---|---|---|---|
| 取景 | 景别 | 近景 | 测量:近景;VLM:中景(半身) |
| 取景 | 机位角度 | 平视 | VLM:平视 |
| 取景 | 构图 | 人物居中,竖屏 | VLM:人物居中,竖屏 |
| 机位 | 拍摄方式 | 三脚架/支架固定 | 测量:混合:固定机位(三脚架/支架/放在桌上) 66%、移动机位(稳定器/手持平移) 34%;VLM:三脚架/支架固定 |
| 机位 | 镜头 | 相机人像/长焦 | VLM:相机人像/长焦 |
| 机位 | 机位/场景 | 两个对视的室内坐姿机位(一个黄色卫衣抱枕女生正面中近景,一个白衬衫绿马甲拿杯女生正面中近景),交替穿插手机诊断报告及代码库截图 | VLM:两个对视的室内坐姿机位(一个黄色卫衣抱枕女生正面中近景,一个白衬衫绿马甲拿杯女生正面中近景),交替穿插手机诊断报告及代码库截图 |
| 机位 | 推测设备 | 专业微单或电影机(浅景深虚化自然)搭配大光圈定焦镜头,领夹麦拾音 | VLM:专业微单或电影机(浅景深虚化自然)搭配大光圈定焦镜头,领夹麦拾音 |
| 打光 | 场景 | 室内;夜晚;客厅沙发 | VLM:室内;夜晚;客厅沙发 |
| 打光 | 主光 | 画面左前方略高,柔光箱 | VLM:画面左前方略高,柔光箱 |
| 打光 | 软硬 | 中等柔度 | 测量:中等柔度;VLM:柔光 |
| 打光 | 补光 | 右侧微弱补光 | VLM:右侧微弱补光 |
| 打光 | 轮廓光 | 无 | VLM:无 |
| 打光 | 眼神光 | 方形 | VLM:方形 |
| 打光 | 可见光源 | 背景左侧暖色台灯 | VLM:背景左侧暖色台灯 |
| 打光 | 色温 | 偏冷(日光/冷白 LED) | 测量:偏冷(日光/冷白 LED);VLM:暖 |
| 打光 | 布光方案 | 左前方柔光主灯 + 背景暖色台灯点缀 | VLM:左前方柔光主灯 + 背景暖色台灯点缀 |
| 打光 | 整体布光 | 温馨的居家夜间暖调照明,背景有台灯点缀暖光源,人物面部有大面积柔光箱打出通透柔和的主光 | VLM:温馨的居家夜间暖调照明,背景有台灯点缀暖光源,人物面部有大面积柔光箱打出通透柔和的主光 |
| 调色 | 调色风格 | 自然(接近原色) | 测量:自然(接近原色) |
- 说明:光比、软硬、色温、景别由主体像素测得(有人脸用人脸,没有用画面清晰区域,后者是估算);平台转码会压暗部,软硬和补光偏保守;机位角度、光源种类、眼神光、轮廓光以看图结果为准。测量和看图不一致时两者都列出。
元数据线索
- 编码器:
Lavf61.7.100
声音拆解

- 整体响度 -16.8 dBFS,峰值 -3.5 dBFS
- 人声:有,占 79% 时长,基频约 247.8Hz(偏女声)
- 背景音乐:占 39% 时长(0.0–10.5s),约 121.6 BPM(也可能是 60.8/243.2),调性 F major(置信 0.795),段落变化点 4.5s, 8.5s
- 剪辑与节拍:0% 的切点落在节拍上(随机约 12%)
声音来源:AI 生成还是现成素材
- 结论:视频类型:AI 视频原生出声(每段画面自带声音) → 人声AI 视频原生对白(随画面生成)(倾向,待确认);音乐现成曲库配乐;音效AI 视频模型随画面生成(原生音频)
- 剥离出的音轨:
stems/original.wav(原声)、stems/vocals.wav(人声干声,瞬态音效也会落在这里)、stems/music.wav(配乐 + 环境声) - 视频形式:剧情;AI 画面占 41%,实拍占 0%
- 背景音乐:现成曲库配乐(existing_library 73%,ai_generated 13%,popular_song 13%)
- 音乐是给画面垫底的配乐:普通视频的配乐大概率来自现成曲库(先验)
- 人声是说话/旁白而不是唱歌(持续音高占比 0.12):属于「旁白 + BGM」的普通视频形式
- VLM 听感判断:曲库配乐
- 确认方法:在抖音/小红书原视频页面看音乐标签:显示歌名 → 现成曲目;显示「@作者创作的原声」→ 作者自己上传(MV 类多为 AI 歌)
- 确认方法:用汽水音乐/QQ 音乐「听歌识曲」或 ACRCloud 识别:识别得到就是现成歌曲
- 确认方法:听:AI 歌常见咬字含糊、高频发虚带金属感、歌词紧扣画面内容;曲库配乐多为无人声、结构标准、片尾被截断或淡出
- 人声:待确认(ai_video_native 44%,human_recording 44%,tts 12%)
- VLM 判断为真人声音
- 背景声在每个切点跳变、画面是 AI 视频:人声很可能是视频模型连同画面一起生成的(如 Seedance/Veo/H3 原生音频)
- 音效:AI 视频模型随画面生成(原生音频)(ai_native 71%,library_editor 24%,live_sync 6%)
- 背景声/环境声在切点跳变(切点 24.7dB vs 镜头内 9.4dB),且画面是 AI 视频:每段自带的音效/环境声是视频模型原生生成的
- 逐段原生音频检测:切点处背景声变化 24.7dB,镜头内 9.4dB(比值 2.63)→ 每段画面自带声音
音效(1 处;来源 vlm=大模型听出,deterministic=信号检测的候选,置信度低)
| 时间 | 类型 | 描述 | 对应画面 | 来源 |
|---|---|---|---|---|
| 10.76s | pop | deterministic |
声音复刻方案
- voice(A01-narration):真人口播/对白,女声双人对话:角色A为年轻居家短发女性(清脆疑惑),角色B为戴帽知性女性(沉稳从容、指导者音色),语速适中,节奏明快,对话自然生活化 → capsule-cinema DoubaoTTSTool / UniversalTTSTool(或 MiniMax 克隆音色);需要卡原时间窗时用时长可控 TTS(A02)
- music(A03-music):低调轻柔的无旋律环境铺底;专注、微悬疑且温和;121.6 BPM;F major → 原曲倾向现成曲库配乐:按 BPM/情绪/调性在曲库检索同类曲,或用 AI 生成相近风格的免版权曲
- sfx(A04-sfx):1 个音效 → 原片音效随 AI 视频片段一起生成:复刻时用支持原生音频的视频模型(Seedance 2.x / Veo 3.1 / Kling)直接出声,或视频生音效(HunyuanVideo-Foley)
- ambience(A04-sfx):安静的室内交谈氛围 → 环境声素材或视频生音效模型
- 混音:人声干脆清晰居于绝对前景,BGM音量极低仅做垫底支撑,无明显音效干扰
结构与文案(VLM)
- 概括:通过居家博主与专业导师的双人情景对话,展示开源小红书账号诊断工具对笔记封面和标题的诊断及优化建议过程。
- 形式:剧情;钩子:开门见山抛出痛点截图与争议话题:笔记刚发21分钟就被判定九成概率扑街,瞬间吸引自媒体创作者注意。
- 旁白:human 女声双人对话:角色A为年轻居家短发女性(清脆疑惑),角色B为戴帽知性女性(沉稳从容、指导者音色);音乐:低调轻柔的无旋律环境铺底;字幕:居中偏下白色无衬线体,黑边描边,顶部常驻醒目标题「笔记没人看,先别删」
- 整体判断:实拍结合屏幕录屏/截图剪辑。两名角色(或一人饰两角)精心布置灯光与服化道进行实景实拍,后期穿插 Markdown 诊断报告与 GitHub 开源界面进行产品安利。
- 0.0–2.83s · 引入痛点 · 这条才发二十一分钟,就被判九成扑街?
- 2.83–5.83s · 诊断原因 · 封面顺序反了,带钩子那张埋在第三张。
- 5.83–10.54s · 原理解释 · 它怎么知道哪张有钩子?它对比了同赛道前九名,第一张全有钩子。
- 10.54–15.7s · 解决方案与门槛 · 连改法都给了?三个新标题都写好了,前提是你得自己配一个会看图的大模型。
- 15.7–19.3s · 行动号召 · 行,下回发了没人看,先别删,拿它查查。
画面里的真实素材
共 5 个镜头、11.17s(59%)的画面里有真实素材(录屏、截图、照片、嵌入视频),复刻时要拿到原文件,不能用模型生成替代:
- 镜头 #1(00:00.000):录屏素材,画面局部 x0% y31% 宽100% 高37%
- 镜头 #4(00:03.875):录屏素材,画面局部 x0% y29% 宽100% 高41%
- 镜头 #6(00:07.542):录屏素材,画面局部 x0% y36% 宽100% 高27%
- 镜头 #8(00:11.542):录屏素材,画面局部 x0% y35% 宽100% 高28%
- 镜头 #8(00:11.542):界面截图,画面局部,中央白色区域的图文清单、标题修改建议文本截图
- 镜头 #10(00:16.125):界面截图,画面局部 x0% y22% 宽100% 高69%
- 镜头 #10(00:16.125):界面截图,画面局部,GitHub 移动端仓库页面截图(JuneYaooo/social-account-doctor)
分镜表
| # | 时间 | 时长 | 底层画面 | 置信度 | 素材来源 | 叠加层 | 运镜 | 复刻路线 |
|---|---|---|---|---|---|---|---|---|
| 1 | 00:00.000 | 1.38s | 代码/模板渲染 | 92% | 混合(含真实素材):录屏素材 | — | 平滑运镜 | R01-code-graphics → code_render_spec |
| 2 | 00:01.375 | 1.46s | AI 生成视频 | 72% | AI 生成 | 文字、标题 | 固定(主体在动) | R07-product-hero → capsule_cinema |
| 3 | 00:02.833 | 1.04s | AI 生成视频 | 58% | AI 生成 | 文字、标题 | 固定(主体在动) | R07-product-hero → capsule_cinema |
| 4 | 00:03.875 | 1.96s | 代码/模板渲染 | 91% | 混合(含真实素材):录屏素材 | — | 平滑运镜 | R01-code-graphics → code_render_spec |
| 5 | 00:05.833 | 1.71s | AI 生成视频 | 72% | AI 生成 | 文字、标题 | 固定 | R07-product-hero → capsule_cinema |
| 6 | 00:07.542 | 3.00s | 代码/模板渲染 | 99% | 混合(含真实素材):录屏素材 | — | 平滑运镜 | R01-code-graphics → code_render_spec |
| 7 | 00:10.542 | 1.00s | AI 生成视频 | 92% | AI 生成 | 文字、标题 | 固定(主体在动) | R07-product-hero → capsule_cinema |
| 8 | 00:11.542 | 1.92s | 代码/模板渲染 | 59% | 混合(含真实素材):录屏素材、界面截图 | — | 平滑运镜 | R01-code-graphics → code_render_spec |
| 9 | 00:13.458 | 2.67s | AI 生成视频 | 66% | AI 生成 | 字幕、标题 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 10 | 00:16.125 | 2.92s | 代码/模板渲染 | 50% | 混合(含真实素材):界面截图 | — | 平滑运镜 | R01-code-graphics → code_render_spec |
逐镜详情
#1 00:00.000–00:01.375 · 代码/模板渲染;引入真实素材(录屏素材)

- 概率:代码/模板渲染 91%,屏幕录制/截图 7%,3D 渲染 1%(fused)
- 素材来源:混合(含真实素材):录屏素材
- 录屏素材:浅色界面面板内有 9 处文字(其中 9 处小字号)
- 可能的工具:剪映
- 纹理呈渲染特征:平坦色块 74%、95% 像素仅用 23 种颜色、横竖直边 31%
- 平坦底色上有大量细小高频细节(小字号文字/界面),像截图或文档画面
- [VLM] 深灰纯色背景搭配上下大字标题排版
- [VLM] 居中卡片为平面排版文本框,文字清晰锐利无失真
- [VLM] 中间图文卡片包含水平滑动位移动效
- 画面:竖屏信息流排版视频,深色背景上下带有标题字幕,中央白色卡片展示笔记诊断文字,卡片整体向左微移。
- 文字轨(画面内容文字/bottom):这条才发二十一分钟
- 文字轨(画面内容文字/middle):0.TL;DR一这条会爆吗? / 不会。9成扑街概率。预计24h数据:5-15赞/1-3评/3-8收藏 / 不会。9 成扑街概率。预计 24h 数据:5-15 赞 /1-3 评 / / α 不会。9 成扑街概率。预计 24h 数据:
- 文字轨(画面内容文字/middle):核心诊断(三个一票否决项): / 1.封面致命错位一第1张是无字插画(D实物展示型,0钩子),唯一带钩子的「设计师 / 了J大字图被埋到第3张。小红书CTR只看第1张→直接判死刑。 / 1.封面致命错位一第1张是无字插画(D实物展示型,0钩子),唯一带钩子的「设计
- 文字轨(画面内容文字/middle):2.正文承诺没兑现一标题/desc都说「附提示词J,但3张图全是效果图+1句吐槽 / 词文本。打开来的人会觉得被骗。 / 3.冷启信号已经走弱一21分钟3赞1评2收藏,作者历史10条平均3.6赞(全是日 / 2.正文承诺没兑现一标题/desc都说「附提示词J,但3张图全是效果图+1句吐槽
- 复刻:代码渲染:用 Remotion/HTML 按文字轨与版式重建,100% 可控,不需要生成模型;需要用户提供真实素材:录屏素材(画面局部 x0% y31% 宽100% 高37%)
#2 00:01.375–00:02.833 · AI 生成视频 + 代码/剪辑叠加(文字标注、标题)

- 概率:AI 生成视频 72%,数字人口播 21%,3D 渲染 2%(fused)
- 素材来源:AI 生成
- 可能的工具:Hailuo
- 低照度画面:36% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.42、用色 123 种、平坦块 9%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.55):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 手指握持手机姿态略显僵硬与塑胶感
- [VLM] 眼镜镜框边缘光影与皮肤融合处有轻微 AI 渲染不自然感
- [VLM] 面部及皮肤质感极其光滑且泛有典型 AI 渲染光泽
- 画面:夜晚室内,短发戴眼镜女子盘腿坐在沙发上,抱着抱枕拿着手机,表情略带惊讶地自言自语。镜头固定中景。
- 拍法/打光:近景;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.2 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):就被判九成扑街?
- 文字轨(标题/top):笔记没人看,先别删
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:真实摄影质感,年轻短发中国女子戴浅绿色复古眼镜,身穿黄色连帽衫,夜晚盘坐在客厅沙发上,胸前抱抱枕,单手拿着手机,背景有暖色落地灯与室内绿植,柔和电影光影,中景,平视视角,竖屏。
- 视频提示词:固定镜头,女子微微张嘴说话,神情略带困惑与惊讶,眼睛注视前方,手指轻微握持手机,头部轻微活动,身体保持坐姿稳定,柔和夜间光影流转。
#3 00:02.833–00:03.875 · AI 生成视频 + 代码/剪辑叠加(文字标注、标题)

- 概率:AI 生成视频 54%,实拍 38%,数字人口播 4%(fused)
- 素材来源:AI 生成
- 低照度画面:47% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.38、用色 98 种、平坦块 8%
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 人物眼周微表情、眨眼和口型自然流畅,无AI面部扭曲或闪烁
- [VLM] 手指关节、指甲边缘与茶杯接触处物理透视真实严谨
- [VLM] 背景书架、台灯光斑及景深虚化符合真实光学镜头散焦特性
- [claude 看图] 和 #2、#5、#7 是同一场景、同一角色,这些镜头已判为 AI 视频
- [claude 看图] 人物皮肤过于光滑、光线均匀,背景书架细节糊成一片,没有实拍的噪声
- 画面:戴黑色报童帽和圆框眼镜的短发女性坐在书房扶手椅上,双手捧着马克杯说话,背景为暖色台灯与书架,中近景固定机位实拍。
- 拍法/打光:近景;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 2.0:1(相差 1.0 档);中等柔度
- 文字轨(文字/bottom):封面顺序反了
- 文字轨(标题/top):笔记没人看,先别删 / 笔记没人看,先别册
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:写实摄影,一位戴黑色报童帽和细圆框眼镜的年轻东亚短发女性,身穿白衬衫与深绿马甲,双手端着浅色陶瓷马克杯坐在米白色扶手椅上,背景是虚化的夜晚书架和暖黄色台灯,电影质感,柔和暖色照明,竖屏构图。
- 视频提示词:固定机位近景拍摄,戴报童帽和眼镜的年轻女性端着咖啡杯自然说话、眨眼,面部神情从微思索变为柔和微笑,双手稳定捧着杯子,背景台灯光影稳定,电影感室内光线。
#4 00:03.875–00:05.833 · 代码/模板渲染;引入真实素材(录屏素材)

- 概率:代码/模板渲染 90%,屏幕录制/截图 8%,3D 渲染 1%(fused)
- 素材来源:混合(含真实素材):录屏素材
- 录屏素材:浅色界面面板内有 10 处文字(其中 10 处小字号)
- 可能的工具:剪映
- 纹理呈渲染特征:平坦色块 60%、95% 像素仅用 41 种颜色、横竖直边 34%
- 平坦底色上有大量细小高频细节(小字号文字/界面),像截图或文档画面
- [VLM] 竖屏信息流排版,深灰背景搭配居中卡片展示
- [VLM] 中间卡片展示小红书图文轮播分析,包含平移缩放动效(向左平移显示第2、3张图)
- [VLM] 顶部与底部包含固定排版字幕标题
- 画面:竖屏信息流教学动画,深色背景居中展示图文卡片排版分析,画面从左侧第1张逐步平移放大展示第2、3张卡片内容及文案钩子。
- 文字轨(画面内容文字/bottom):带钩子那张埋在第三张
- 文字轨(画面内容文字/middle):image2王炸 / 效果,设计师 / 又又又要失业了
- 文字轨(画面内容文字/middle):BRASS / SIRMINGHAM / 第3张一唯一带钩子的「设计师又又又 / 要失业了」,被理
- 文字轨(画面内容文字/middle):BRASS BIRMINGHAM,0字钩子 / 封面)一蒸汽朋克插画 / 第2张一双曝光精灵女王,美但仍无字 / RMINGHAM,0字钩子
- 复刻:代码渲染:用 Remotion/HTML 按文字轨与版式重建,100% 可控,不需要生成模型;需要用户提供真实素材:录屏素材(画面局部 x0% y29% 宽100% 高41%)
#5 00:05.833–00:07.542 · AI 生成视频 + 代码/剪辑叠加(文字标注、标题)

- 概率:AI 生成视频 72%,数字人口播 21%,3D 渲染 2%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling
- 低照度画面:37% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.41、用色 119 种、平坦块 9%
- 逐帧清晰度呈周期性起伏(周期 4 帧,相关 0.46):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 人物面部与皮肤质感呈现典型的Midjourney/AI写实质感,过于平滑且泛微光
- [VLM] 动作期间嘴唇开合与眼神运动带有AI图生视频(I2V)的轻微形变和漂浮感
- [VLM] 手指握持手机的边缘与抱枕交界处微小结构略显融化与不稳定
- 画面:戴蓝框眼镜短发女生盘腿坐在昏暗客厅沙发上,抱着抱枕看手机,抬头惊讶说话,固定镜头,室内暖光与屏幕冷光对比。
- 拍法/打光:近景;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):它怎么知道哪张有钩子?
- 文字轨(标题/top):笔记没人看,先别删
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:真实摄影风格,夜晚昏暗客厅,年轻亚洲短发女生戴浅蓝色粗框眼镜,身穿黄色连帽卫衣,盘腿坐在沙发上抱着米白色抱枕,手持发光的智能手机,惊讶张嘴抬头望向前方,背景虚化有一盏暖光落地灯,电影质感,冷暖光影对比,8k细节
- 视频提示词:固定机位中景,戴眼镜的短发女生在夜晚沙发上低头看着发光的手机,随后惊讶地张嘴抬头看向镜头前方说话,面部表情灵动,身体保持盘坐,背景暖光落地灯柔和虚化,保持写实电影感摄影质感
#6 00:07.542–00:10.542 · 代码/模板渲染;引入真实素材(录屏素材)

- 概率:代码/模板渲染 98%,3D 渲染 0%,屏幕录制/截图 0%(fused)
- 素材来源:混合(含真实素材):录屏素材
- 录屏素材:浅色界面面板内有 7 处文字(其中 7 处小字号)
- 可能的工具:剪映/After Effects
- 纹理呈渲染特征:平坦色块 79%、95% 像素仅用 11 种颜色、横竖直边 33%
- 平坦底色上有大量细小高频细节(小字号文字/界面),像截图或文档画面
- [VLM] 纯色平整背景
- [VLM] 边缘锐利的几何色块(白色卡片)
- [VLM] 清晰无损的排版文字
- [VLM] 卡片匀速直线向上滚动的标准动画
- 画面:深灰背景上,一张包含列表文字的白色卡片匀速向上滚动,上下方有固定的字幕。
- 文字轨(画面内容文字/bottom):它对比了同赛道前九名 / 第一张全有钩子
- 文字轨(画面内容文字/middle):6.共性总结一用户该抄什么 / top9都在做的事(你这条1个都没做): / top9都在做的事(你这条1个都没做): / top9都在做的事(你这条1个都没做):
- 文字轨(画面内容文字/middle):1.封面有大字/强视觉钩子一9/9全做了,你0/3 / 2.明确身份锚定一设计师/老师/家长/品牌方/二次元一你的封面没有人群 / 3.反差/反认知一7/9(Altman直播/AI写试卷/Al仿官方海报...)一 / 2.×明确身份锚定一设计师/老师/家长/品牌方/二次元一你
- 文字轨(画面内容文字/middle):4.具体可见的「原型对比」一5/9用截图/海报/试卷做「Alvs真品」对照,你纯 / 5.垂直号沉淀一7/9是AI/设计/工具垂类号,标签明确,你是「AI资讯日报」杂 / 4.具体可见的「原型对比」一5/9用截图/海报/试卷做「AIvs真品」对照,你纯 / 3.×反差/反认知一7/9(Altman直播/Al写试卷/Al仿官)
- 复刻:代码渲染:用 Remotion/HTML 按文字轨与版式重建,100% 可控,不需要生成模型;需要用户提供真实素材:录屏素材(画面局部 x0% y36% 宽100% 高27%)
#7 00:10.542–00:11.542 · AI 生成视频 + 代码/剪辑叠加(文字标注、标题)

- 概率:AI 生成视频 77%,数字人口播 15%,实拍 7%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling
- 低照度画面:38% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.39、用色 119 种、平坦块 10%
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 手指握持手机边缘细节略有AI平滑感
- [VLM] 面部及光影虽然写实但呈现典型AI生图特征质感(如MJ/Flux面部特质)
- [VLM] 说话口型动作具有AI图生视频的微动特征
- 画面:戴眼镜年轻女性夜间盘腿坐在沙发上抱抱枕看手机,表情惊讶开口说话。中景固定机位,室内暖光与手机冷光交织。
- 拍法/打光:近景;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.1 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):连改法都给了?
- 文字轨(标题/top):笔记没人看,先别删
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:写实摄影,夜晚温馨客厅,短发年轻东亚女性戴青色圆框眼镜,身穿黄色连帽卫衣,盘腿坐在沙发上抱着米色抱枕,手持发光智能手机,惊讶微张嘴看屏幕,手机冷光映照面部,背景有暖色落地灯和窗户,浅景深。
- 视频提示词:固定镜头,戴眼镜女孩抱抱枕坐在沙发上看着手机,惊讶地张大嘴巴说话,眼神聚焦屏幕,手机屏幕蓝白冷光微微闪烁照亮面部,动作自然微动。
#8 00:11.542–00:13.458 · 代码/模板渲染;引入真实素材(录屏素材、界面截图)

- 概率:代码/模板渲染 59%,屏幕录制/截图 18%,3D 渲染 10%(fused)
- 素材来源:混合(含真实素材):录屏素材、界面截图
- 录屏素材:浅色界面面板内有 10 处文字(其中 10 处小字号)
- 可能的工具:剪映
- 纹理呈渲染特征:平坦色块 78%、95% 像素仅用 9 种颜色、横竖直边 31%
- 平坦底色上有大量细小高频细节(小字号文字/界面),像截图或文档画面
- [VLM] 画面主体为图文排版的文档截图/卡片,整体进行缓慢平滑的向下滚动或平移
- [VLM] 文本边缘清晰无变形,非AI视频生成
- [VLM] 上下有固定的标题和副标题装饰字幕,中央卡片做缓慢位移动效
- 画面:深色背景上的运营笔记改写指南图文卡片,画面上下带有标题字幕,中部图文内容呈垂直平移滚动浏览动效。
- 文字轨(画面内容文字/bottom):三个新标题都写好了
- 文字轨(画面内容文字/middle):P0一现在就改(5分钟内,决定生死) / 1.把第3张设成封面一编辑笔记→拖图重排序→第3张拉到第1位。预期CTR从估算2 / 8%,可能进二级池。 / 1.把第3张设成封面一编辑笔记→拖图重排序→第3张拉到第1位。预期CTR从估算2
- 文字轨(画面内容文字/middle):2.正文补提示词一至少给一段ChatGPTimage-2的prompt例子,兑现 / of British Industrial Revolution illustr / sepia tone..." / 3.改标题一套公式1(数字+人群+效果)重写:
- 文字轨(画面内容文字/middle):o候选1:「3个提示词,设计师又要失业了|GPTimage-2实测J / o候选2:「我用GPTimage-2复刻了爆款桌游封面,附提示词] / o候选3:「GPTimage-2双曝光神技,设计师抄作业] / 3.改标题一套公式1(数字+人群+效果)重写:
- 复刻:代码渲染:用 Remotion/HTML 按文字轨与版式重建,100% 可控,不需要生成模型;需要用户提供真实素材:录屏素材(画面局部 x0% y35% 宽100% 高28%)、界面截图(画面局部)
#9 00:13.458–00:16.125 · AI 生成视频 + 代码/剪辑叠加(字幕、标题)

- 概率:AI 生成视频 66%,实拍 16%,数字人口播 9%(fused)
- 素材来源:AI 生成
- 可能的工具:HeyGen / D-ID / 剪映数字人
- 低照度画面:46% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.40、用色 96 种、平坦块 8%
- [VLM] 人物身体和拿杯子的手完全静止
- [VLM] 仅头部和嘴部有动作,符合音频驱动数字人特征
- [VLM] 背景完全静止无变化
- 画面:中景,戴帽眼镜女性捧杯说话,背景温馨书房。
- 拍法/打光:近景;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.8:1(相差 0.9 档);中等柔度
- 文字轨(字幕/bottom):前提是你得自己配 / 一个会看图的大模型
- 文字轨(标题/top):笔记没人看,先别删 / 笔记没人看,先别册
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:中景,年轻亚洲女性,短发,圆眼镜,黑报童帽,白衬衫,深绿马甲,坐沙发捧白马克杯。背景温馨书房,暖色台灯,虚化。左前方柔光,写实。
- 视频提示词:图片作底图,音频驱动数字人,嘴型同步,头部微动眨眼,身体背景静止。
#10 00:16.125–00:19.042 · 代码/模板渲染;引入真实素材(界面截图)

- 概率:代码/模板渲染 50%,3D 渲染 25%,屏幕录制/截图 21%(fused)
- 素材来源:混合(含真实素材):界面截图
- 界面截图:浅色界面面板内有 30 处文字(其中 29 处小字号)
- 可能的工具:剪映
- 纹理呈渲染特征:平坦色块 73%、95% 像素仅用 13 种颜色、横竖直边 51%
- 平坦底色上有大量细小高频细节(小字号文字/界面),像截图或文档画面
- [VLM] 画面主体为 GitHub 项目移动端网页界面截图(JuneYaooo/social-account-doctor)
- [VLM] 画面整体随时间均匀缓慢放大推近,无内部交互动画或光标,属于静态截图的关键帧推镜(Ken Burns)
- [VLM] 顶部与底部带有纯色背景和后期加贴的标题及字幕
- 画面:移动端 GitHub 仓库主页截图,展示项目文件列表,镜头平缓向前推近放大。
- 文字轨(画面内容文字/bottom):.env.example / 2weeks ago / .gitignore / 2weeksago
- 文字轨(画面内容文字/bottom):口 / LICENSE / 5 monthsago / README.md
- 文字轨(画面内容文字/bottom):行,下回发了没人看 / 先别删,拿它查查
- 文字轨(画面内容文字/middle):<>Code / Issues / Pullrequests / Actions
- 复刻:代码渲染:用 Remotion/HTML 按文字轨与版式重建,100% 可控,不需要生成模型;需要用户提供真实素材:界面截图(画面局部 x0% y22% 宽100% 高69%)、界面截图(画面局部)
说明
- 确定性取证对「是否在动、是否整图推拉、是否渲染纹理、是否 24→30 帧率转换」很可靠;对实拍 / AI / 3D 的区分要依赖 VLM 与人工复核。
- 元数据经平台转码常被清除,缺失不代表没有。